lunes, marzo 26, 2007

Starting Area (Orígenes: Primera Parte)

Bueno, me lanzo al final. Llevo varios dias intentando ver como explico lo de la starting area, lo he explicado muchas veces y lo he puesto en marcha varias mas, y funciona, pero no se porque, escribirlo, me da un poco de respeto y lo he estado evitando. Pero en fin allá voy.

La Starting Área (STA) tiene dos carácterísticas principales, la primera es que está ligada intrínsecamente al concepto de metodologías ágiles y la segunda es que tiene fecha de caducidad.


El concepto es el siguiente: La idea de la Starting Area la empecé a madurar al encontrarme "malas" implementaciones de la Staging Area. La Staging Area (STG) por definición es el área donde se ejecutan los procesos ETL y que tiene un caracter volatil, es decir al finalizar el proceso, la Staging debe de quedar vacia, sin contenido. Sin embargo, me encontraba que muchas implementaciones, tanto propias, como de otros arquitectos de DWH, acababan dejando información en la STG. En mi época más purista blasfemaba cada vez que me encontraba una STG con datos, pero a medida que trabajaba con estas arquitecturas me daba cuenta que si bien en algunos casos era pura negligencia, en otros casos incluso yo mismo estaba dejando esos datos "permanentes" de forma deliberada. Esto siempre ocurría en implantaciones con mucha limpieza de ETL, al final decidia no borrar la STG para poder ir haciendo pruebas en desarrollo y no tener que esperar a cargar de nuevo los origenes. Al final, tenía un proceso ETL en el que en lugar de finalizar con el borrado de la tabla, dejaba los datos hasta la siguiente ejecución , con lo que cada proceso se iniciaba borrando los datos que habían sido utilizados en la anterior ejecución.

Obviamente esto solo lo hacía durante el desarrollo del DWH y una vez lo ponía en marcha cambiaba el modelo a la ejecución normal dejando la STG totalmente vacia. Y así lo estube haciendo hasta que cierto día en uno de mis clientes, alguien cambió un elemento de una jerarquía en el operacional por error, una operación que el ERP validó pero que no tenia sentido lógico, error que se propagó a la información que daba el DWH, y que nadie comprobó hasta al cabo de varios dias. Con lo que teníamos que rehacer el DWH y con urgencia, porque al dia siguiente había la reunión del comité de dirección. Me avisaron a las 9:00 de la mañana, tardé en borrar la información erronea unos 20 minutos y tube que esperarme hasta las 20:00 horas que cerraban el turno para poder conectarme al operacional y lanzar la carga del DWH. A las 21:00 ya estaba cargado y solventado, y a las 21:30 cogia el tren hacia mi casa pensando "esto no tiene sentido, tiene que haber una manera mejor de hacer las cosas". Y ahí fué cuando empecé a crear mi idea de la Starting Area.

Su primera versión consistió en no borrar el primer estadio de todos los procesos ETL del DWH, dejarlo como en el modo de desarrollo, es decir borrando al iniciar, pero solo en el primer paso de cada proceso ETL, con el que "todo empieza", de ahí su nombre "Starting Área". Eso me daba la ventaja de poder ejecutar el proceso anterior de nuevo sin necesidad de esperar a la ventana de tiempo del proceso de carga, sin embargo no me solucionaba nada cuando tenía que rehacer varias ejecuciones anteriores del proceso ETL, o si tenia que recargar TODO el DWH.

Así que di paso a mi segunda versión que solamente utilizaba en desarrollo y que consistía en hacerme una copia exacta de las fuentes de datos en un repositorio diferente. Y cuando estaba haciendo esto me di cuenta que estaba volviendo a los origenes del DWH, en los que haciendo una copia "exacta" del operacional se construían los sistemas decisionales. Y entonces me dí cuenta que algo se me estaba escapando y que así no iba bien, que tendría que volver a los origenes y ver que estaba pasando. Fué así como empecé a descubrir a Inmon y como me replanteé las funciones que debería tener la Starting Area.

Obviamente la Starting Area (STA) no se ha quedado en simplemente eso, ha evolucionado mucho mas, dando soporte a otras necesidades que me he encontrado, como la hetorogeneidad de fuentes que comentaba en el post anterior, el reporting operacional (funcionalidades de ODS) y mejoras en los procesos de calidad del dato, siempre desde la perspectiva de las metodologías ágiles, en el que el tiempo de desarrollo y de entrega ha de ser de ciclo corto.

Pero ya se me ha hecho muy tarde y eso lo dejaré para el próximo post.

miércoles, marzo 14, 2007

La heterogeneidad de fuentes complica la toma de decisiones

Comunmente nos encontramos con entornos empresariales en los que el ERP es de un fabricante, el CRM de otro, el SCM es un desarrollo a medida, ninguna de las aplicaciones se ejecuta en el mismo sistema operativo, casi todas están desarrolladas en diferente lenguajes de programación, y para diferentes plataformas, tenemos múltiples bases de datos con información crucial y no contrastada, y en los que el CIO se tira de los pelos día si y día también.

Son generalmente sistemas de información con una larga evolución histórica y que se han visto abocados sin remedio a convivir con multitud de subsistemas. Citaré cuatro ejemplos de cómo se puede haber originado, y seguro que alguno de vosotros se encuentra en esa misma situación:

* Heterogeneidad originada por el paso del tiempo. Nuestra empresa inicialmente comenzó con un ERP sobre un AS400, con el paso del tiempo vió la necesidad de un SCM, pero como las tecnologías habían cambiado decidió hacer una aplicación a medida en un entorno cliente/servidor. Pasaron unos años más y la web era lo último y se decidió poner un sistema CRM estándar y basado en J2EE, etc, etc.

* Heterogeneidad originada en departamentos. Algunos departamentos de nuestra organización tienen necesidades diferentes y/o muy específicas, que les han hecho optar por SI departamentales, en los que existe un alto grado de independencia con respecto al SI organizacional.

* Heterogeneidad originada por fusiones. Nuestra empresa, se ha fusionado con otra empresa heredando todos sus SI y duplicando funcionalidades. Son entornos en los que nos podemos encontrar con dos ERPs conviviendo a la vez.

* Heterogeneidad originada por descentralización. Tenemos muchas filiales distribuidas geográficamente y es difícil controlar la evolución de los SI en cada una de ellas debido a que poseen un alto grado de independencia necesario para adaptarse a las características especiales de su zona geográfica en concreto.

¿Cómo podemos implementar un sistema que nos ayude a tomar decisiones en estos entornos tan caóticos?.
¿Cuales son las pautas metodológicas que nos harán crear un sistema decisional que no tenga los pies de barro?.

Mi solución mezcla ingredientes de Masterdata, ODS y Staging Area, claro esta sazonada con un pizca de Inmon, es lo que llamo la Starting Area y a la que pienso dedicar el próximo post.
miércoles, febrero 28, 2007

Antonio Valle, la disfunción cromática y la disonancia cognoscitiva

La ventaja de poder colaborar con Antonio Valle es que siempre se saca algo de la chistera que te deja con la boca abierta y con cara de tonto. El martes fue uno de esos dias y hasta hoy no te tenido tiempo de "novelar" lo ocurrido.

Estabamos en una charla animada, en una consultoría, evaluando los posibles escenarios finales y los resultados que se podrían derivar de que un determinado KPI /Métrica, apareciera en rojo en el cuadro de mando. A lo que yo argumenté que si sucedia ese hecho, era un claro indicador de que estaba pasando en hecho X y que teníamos obligatoriamente que tomar la decisión Y.

A lo que Antonio, se me quedó mirando, hizo una pausa de esas que tanto le gustan y nos espetó a todos los presentes en la reunión : "Bueno, eso será así siempre y cuando el analísta no tenga disonancia cognoscitiva o disfunción cromática".

Y ahí se me quedó la cara de tonto, pero es verdad, todo sistema decisional muestra la información de la manera objetiva y nos creemos que con eso es suficiente que ya esta hecho el trabajo, pero aún faltan dos procesos:
  • La recepción de la información en el cerebro del análista
Casi todas las herramientas de BI, muestran la información o a través de reports o cuadros de mando o complejas anílíticas interactivas....¿pero llega esta información de forma correcta al receptor? ¿Que pasa si muestras gráficos de barras, tendencias, diagramas de pareto, alarmas, códigos semáforicos y el analista sufre disfunción cromáticamas conocida como daltonismo?
Imaginaos que teneis esta gráfica triple y simplemente teneis que explicar porque no se ha conseguido el objetivo (en azul) y las discrepancias entre lo planificado (en verde) y lo ejecutado (en rojo).


  • La ejecución del proceso físico de toma de decisiones en el analista.
Que pasa si la información que recibes entra en frontal conflicto con tu paradigma decisinal, que pasa si esa información hace que tengas que tomar una decisión que está en total disonancia con lo que tú realmente piensas. ¿la tomarás igualmente o cambirás el peso que esta información tiene en tu toma de decisiones?. Eso es lo que se llama disonancia cognitiva y que en el artículo que os linko se resume como:

"Es el conflicto mental que abunda en la experiencia cuando se presentan evidencias de que una creencia propia o asunción personal es incorrecta. La teoría de la disonancia cognoscitiva afirma que hay una tendencia en la gente a reaccionar para reducir tal disonancia. Una persona puede evitar la nueva información o convertirse manipulador de argumentos para mantener su creencia o juicios.
Por ejemplo, Erlich, Guttman, Schopenbach y Mills (1957) mostraron que los nuevos compradores del coche evitan selectivamente los anuncios de la lectura
para los modelos del coche que no eligieron, mientras que por otra parte los atrajeron a los anuncios para el coche ellas eligieron. "

Ambos procesos pueden sufrir fallos que nos hagan tomar una decisión erronea, y eso no hay sistema decisional que lo pueda solventar.

Así que mantened vuestras mentes abiertas :-D


miércoles, febrero 14, 2007

Green Lantern Methods for Redesign (GLMR)

Despues de darle muchas vueltas, esta tarde he pasado a la accióm. Junto con mi amigo Marti Ibarz, nos hemos puesto a darle forma a una posible metodología ágil de rediseño de data warehouse. El porqué me he decidido finalmente a hacer una metodología propia para este proyecto y no reutilizar ninguna de las existentes, es principalmente el hecho de que la casuística de un proyecto de rediseño no ha de ser la misma que la de un proyecto que empieza desde cero. También me da la oportunidad de probar una metodologia ágil en un proyecto de menor riesgo.

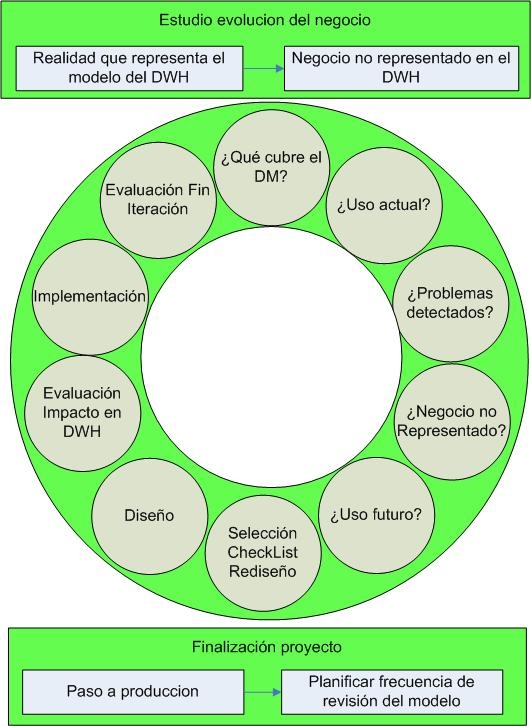
El esqueleto resultante es este que os comento a continuación, y que a partir de ahora voy a llamar Green Lantern Methods for Redesign o acronizando un poco GLMR.

GLMR será un conjunto de métodos que podrán aplicarse a cualquier proyecto de rediseño de aplicaciones, la primera versión, claro esta, será (porque aún no la tengo hecha) la versión para Data Warehousing (GLMR for Data Warehousing) pero animo a cualquiera a que realice su propia versión para proyectos de rediseño en otros ámbitos.

El esquema principal se compone de una primera fase lineal en la que nos haremos una idea de la vision global y de como la evolución del negocio ha hecho que nuestro sistema sea insuficiente para las necesidades de la organización, a esta fase le sigue un ciclo iterativo en el que se rediseñan los datamarts y en el que se obtiene check list de implementacion de funcionalidades y optimizaciones para cada datamart. El proceso finaliza con otra fase lineal en la que se ponen los cambios en marcha y se planifica los criterios que harán que en un futuro se desencadene de nuevo otra reingenieria.


Es una version muy simplificada sobre la que seguiré trabajando, los siguientes pasos que voy a dar implican la definicion de las tareas de cada fase, la documentación resultante (que será la mínima necesaria) , los roles que han de intervenir (donde el usuario final ha de formar parte del equipo con un papel destacado) y las reuniones e hitos de control.

Si, ya lo se, TODAVÍA ESTA MUY VERDE.... je je je (no he podido resistirlo), pero creo que va a dar un buen resultado.

Como siempre admito sugeriencias, aunque ya estoy perdiendo la esperanza :-(


jueves, febrero 01, 2007

¿Dynamic Systems Development Method para DWH?

Después de descartar SCRUM mi siguiente metodología candidata es DSDM, y creo firmemente que dentro de las metodologías ágiles puede ser la adecuada, a ello me ha llevado mi gran intuición y el white paper llamado "DSDM and Data Warehousing" que yo con pocas pistas enseguida pillo el concepto. ;-D

Veamos un poco de que se trata esto de DSDM


DSDM se ha desarrollado teniendo como ideas fundamentales:

· Nada es construido a la perfección a la primera.

· La vieja regla del 80-20 es cierta ( el 80% de las funcionalidades del proyecto se realizan con el 20% del tiempo, y el 20% restante, los detalles, consumen el 80% del tiempo restante)

· Es improbable que alguien conozca todos los requisitos del sistema desde el primer día.


De estas ideas nace una metodología cuyas principales características son:

· Un proceso iterativo e incremental

· Un equipo de desarrollo con el que el usuario final trabaja conjuntamente.


Este principio me puede ser util para la reingenieria de data warehouse que os comentaba en el anterior post. La idea dominante en DSDM es que tiempo y recursos se mantienen como constantes y se ajusta la funcionalidad de acuerdo con ello. Es decir, la idea no es “¿cuánto me va a costar desarrollar este sistema?” sino que mas bien es “Con este tiempo y estos recursos ¿cuántas de las funcionalidades del sistema puedo hacer. Si hablamos de reingeniria de Data warehousing, seguramente deberiamos preguntarnos: ¿Cuanto podemos optimizar y cuantos nuevos enfoques decisionales podemos añadir a los existentes?

Entiendo que la naturaleza de las preguntas necesariamenta ha de ser específica para el proyeco, pero las dos características princiapels encajan a la perfección en el proyecto que quiero desarrollar.

Sigamos pues por este camino.

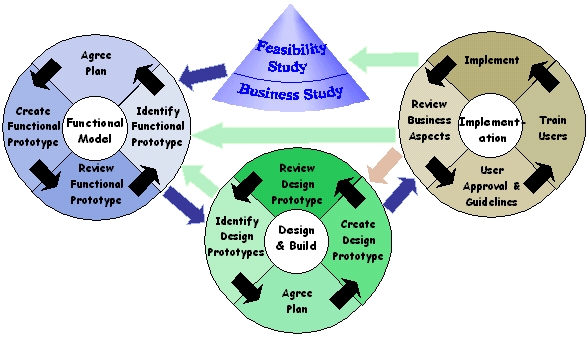
DSMD propone cinco fases, las tres últimas son iterativas:

· Estudio de la viabilidad. Lo primero que se evalúa es si DSDM se puede o no aplicar al proyecto.

· Estudio del negocio. Se estudia el negocio, sus características y la tecnología. Debe crearse el Plan de Prototipado (base del DSDM).

· Modelado funcional. En cada iteración se planea se refinan los procesos funcionales del negocio sobre el prototipo

· Diseño y construcción. Aquí es donde se construye la mayor parte del sistema. El prototipo se vuelve apto para su utilización por parte de los usuarios

· Implementación. Pasamos de un prototipo a un sistema de producción. Se entrena a los usuarios para que lo usen..


En el gráfico queda mas claro (pulsad sobre el para ver mas grande)

Ahora el siguiente paso que tengo que dar es estructurar una metodología de reingenieria de DWH basada en DSDM y probarla.

¿Alguna sugerencia de por donde empezar?


martes, enero 23, 2007

¿SCRUM para DWH?

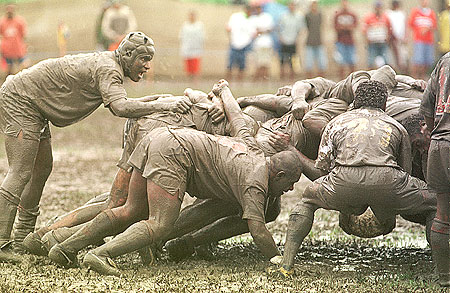
El término SCRUM tiene su origen en el ámbito del rugby, se trata de una posi-ción entrelazada en círculo que toman los integrantes de ambos equipos. El pro-pósito del scrum es el de reiniciar el juego, rápida, segura e imparcialmente, después de una infracción menor o de una detención.

SCRUM es una metodología que nace ajena al desarrollo del software, de hecho sus principios fundamentales fueron desarrollados en procesos de reingeniería por Goldratt, Takeuchi y Nonaka en la década de 1980 y no fueron aplicados al proceso de desarrollo de software hasta 1993 por Jeff Sutherland, siendo formalizada con la colaboración de Ken Schwaber en una presentación en OOSPLA 96.

Eso lo hace muy versatil para desarrollar proyectos de workflow por ejemplo, pero mi duda es si se puede aplicar de forma eficiente a un proyecto de datawarehouse.

A priori, un buen proyecto para aplicarlo sería el de una "reingenieria de un dwh existente", y tengo precisamente tengo una entre manos, asi que voy a decicar este post a "refrescar" los principios sobre los que se basa SCRUM a ver si lo puedo aplicar o no a este proyecto

El Scrum se ha desarrollado teniendo como principios fundamentales:

Principio de requisitos indefinidos de Humphrey: para un nuevo aplicativo, los requerimientos no serán totalmente conocidos hasta que el usuario no lo haya usado.
Lema de Wegner: es imposible definir completamente un sistema iterativo.
El principio de incertidumbre de Ziv en la ingeniería del software: la incertidumbre es inherente e inevitable en el proceso de desarrollo de aplicaciones.

Podríamos decir que Scrum se basa en cierto “caos controlado”, el proceso del ciclo de desarrollo de Scrum parte del conocimiento de que el proceso de desarrollo fundamental del producto esta totalmente indefinido, es incluso caótico, pero establece ciertos mecanismos para controlar esta indeterminación, manipular lo impredecible y controlar la flexibilidad.

Y aqui nos encontramos con la primera pega, SCRUM es segun sus propios autores un.... "Modelo de desarrollo ágil de productos"

"Producto", un dwh NO es un producto que se pueda acabar como ya dije en el post anterior, asi que quizás no sea tan buena idea lo de SCRUM. Pero los principios me parecen muy adecuados. Claro si pensamos en el origen de la metodología es obvio que esta orientada a producto así que no se yo hasta que punto voy a poder aprovecharla.

Pero sigamos viendo, ahora me centraré en el ciclo de vida de Scrum. Este es una analogía de la jugada de rugby de la que recibe su nombre. En Scrum el balón ha de disputarse entre ambos equipos, los jugadores de un equipo se reúnen en circulo y deciden que es lo que van ha hacer, luego se posicionan enfrente del otro equipo de forma entrelazada, con el balón en medio, y comienza la jugada en la que no se sabe que va a pasar, ni quien tendrá el balón ni hacia donde se atacará. El equipo ha de adaptarse rápidamente hacia una jugada ofensiva o defensiva según quien se haya hecho con el balón.

¿Eso me sirve para el rediseño de un DWH? Uy que pinta un poco mal. Si yo ya tengo claro hacia donde tengo que ir, que estructura tengo que optimizar, que usuarios utilizan el sistema y como lo utilizan. ¿necesito esa adaptabilidad tan extrema?. Empiezo a ver que no, pero quiero darle una oportunidad antes de descartarla

En la metodología Scrum se establecen tres fases : pre-juego, juego y post-juego.

En el pre-juego se definen y/o revisan las funcionalidades que ha de tener el sistema, haciendo la lista de funcionalidades que cuando estén completadas podremos decir que el desarrollo del sistema. Dicha lista recibe el nombre de Release Backlog .Una vez hecho esto se elige un subconjunto de estas funcionalidades con el que se va a trabajar el próximo mes, llamado Sprint Backlog y entonces comienza la siguiente fase.

En el juego es donde se desarrolla el Sprint, las reglas de esta fase son sencillas, se distribuyen las tareas para cada miembro del equipo, se trabaja duro y se intentan conseguir el objetivo. Todos los miembros del equipo han de participar en una reunión diaria que en ningún caso deberá exceder los 30 minutos, llamada Sprint-meeting. En esta reunión cada desarrollador debe dar respuesta a tres preguntas:

• Que hizo desde la última reunión.
• Que dificultades se estan teniendo en el desarrollo de la tarea.
• Que va a hacer hasta la próxima reunión diaria.

Al finalizar el Sprint, pasamos a la fase de post-juego, en ella se evalúa la entrega de funcionalidades del Sprint , se ven las tareas pendientes, se evalúa el progreso del proyecto y se redefine el tiempo de entrega del mismo si fuera necesario. En este paso se compara las funcionalidades actuales con el Release Backlog y en el caso de no cumplirse se vuelve a la fase de pre-juego para realizar una nueva iteración. Si por el contrario, sí se cumplen entonces pasamos la creación de la versión final y a la creación de la documentación pertinente.


Pues creo que yo ya lo tengo claro, no me aporta demasiado para una reingenieria de DWH, quizás para un proyecto de DWH nuevo desde cero si que me podría ser útil, pero para una reingeniera de DWH claramente no, porque ya se que funcionalidades ha de dar, y porque no tengo que ir dando pequeñas funcionalidades cada semana, ya que lo tengo bastante mas simple, cuando acabe la reingenieria, desactivaré el antiguo data y conectaré el nuevo data. Y si todo va bien los usuarios no se darán ni cuenta.


Bueno, para finalizar explicaré los roles básicos de SCRUM así os haceis a una idea, os pongo los 4 principales.


• Scrum Master: Es el responsable de asegurar que el proyecto se es-tá desarrollando según las reglas de la metodología Scrum.
• Product Owner. Es el responsable de la lista de funcionalidades (Re-lease Backlog).
• Scrum Team: Es el equipo responsable la organización y ejecución de cada uno de los Sprints.
• User/Customer: Participan en la creación y revisión de la Release Backlog.

Pero a mi me sigue gustando SCRUM, ya que la forma de trabajar que se adopta es muy colaborativa, un equipo de Scrum tiene entre 7 y 9 miembros, a los que se les incentivará para que adopten soluciones ingeniosas y que aprendan de forma conjunta en un ambiente totalmente cambiable pero controlado parcialmente.

A mi, la verdad, me gusta trabajar así. :-D

miércoles, enero 10, 2007

¿Qué debe cumplir una metodología de data warehousing.?

Empezaremos el 2007 mirando un articulo de TDWI llamado "Ten Mistakes to Avoid for Data Warehouse Project Managers" realizado en el segundo trimestres de 2005, vale es un poco antiguo pero me sirve para ilustrar dos conceptos sobre la necesidad de un metodología diferente para los sistemas de dwh.


Los 10 errores que podemos evitar que se comentan en el articulo son:

1) Failing to Use a Methodology (uy que bien me viene para el post de hoy)
2) Ineffective Team Project Structure
3) Failing to involve the business people
4) Failing to have application releases
5) Failing to have an active Project Charter
6) Lack of a readiness assessment
7) Inadequate testing
8) Underestimating Dara Cleansing Efforts
9) Ignoring Metadata
10) Being a Slave to Project Management Tools (uy esta tambien me va bien)


La autora es Larissa Moss del Cutter Consortium , que entre otras cosas ha escrito BI Roadmap: The Complete Lifecycle., vamos que sabe de lo que habla.

En el post de voy a comentar los puntos 1 y 10, el primero y el ultimo
Larissa comenta en estos dos puntos cosas como esta:

" (...) They are often surprised to learn that project managers and project teams must consider approximately 920 tasks when developing a data warehouse. Who can rememner 920 tasks?. No one. But everyone can look up 920 tasks in a methodology!"

920 tareas diferentes, intendad poner eso en una metodología rígida y formal o en una de las tradicionales en cascada que hemos estado utilizando para los grandes proyectos operacionales, sin duda solo con la gestión nos ocuparía la mayor parte del tiempo del proyecto.pero eso no es motivo para que no funcione, nos iremos de plazos seguro, pero no funcionar, eso es decir mucho ¿no?... pues no, no va a funcionar por estos dos motivos:

"(...) a traditional methodology does not include cross-organizational business integration tasks"

"(...) a traditional methodology (...) assumes you are building a product and will not evolve or expand over time"


Ok, no podemos utilizar las tradicionales, pero debemos tener una metodología.


¿Que debe cumplir esa metodologia para que sea util en la creación de un datawarehouse?


1) Que este orientada al cambio y no a la consecución de un producto final.
2) Que gestione el proyecto como cross-funcional a la empresa, una data warehouse no es de un departamento ,es de una empresa, y todos tienen que estar implicados.
3) Debe poder manejar multiples subproyectos a la vez y en paralelo (Etl, data cleasing, reports, querys, KPIs, cubos, etc..)
4) Que posea TODAS las tareas a tener en cuenta, no se trata de que se ejecuten todas, seguramente muchas no serán necesarias, pero no tenerlas incluidas lo único que te asegura es que te olvidarás de una critica y luego tendrás que rehacer el trabjo o algo mucho peor
5) Que utilice los caminos críticos, para su gestión. Es decir que tenga sentido común, centrate en las tareas criticas que puden hacer cambiar la planificación, solo replanifica cuando estas se vean afectadas

¿No os parece que una metodología ágil encajaría perfectamente?

viernes, diciembre 22, 2006

Feliz Navidad (un clásico)


Os deseo a todos una Ágil Navidad y que en este Metodológico 2007 tomeis buenas decisiones ;-D

¡¡¡¡FELIZ NAVIDAD Y PRÓSPERO AÑO 2007!!!!

viernes, diciembre 01, 2006

La metodología como caballo de troya

Uno de los problemas que nos podemos encontrar en las organizaciones es que no estén lo suficientemente maduras para la agilidad como ya comenté en ¿Cuando puedo aplicar una metodología ágil? y en 7 Paradigmas a romper para ser ágiles

Si a esto le unimos la semiestructuración de los procesos decisionales, nos encontramos que para aplicar una metodología ágil en un proyecto de Business Intelligence, tenemos que tener muy claro a que nos estamos enfrentando. Para ello el primer proyecto que se haga de estas características en la organización tiene que tener no solo el caracter de una metodología rigurosa y seria, sino también la característica de "evangelizar", de ser un caballo de Troya que infecte a todos los ambitos de desarrollo de la organización.

Un metodología (que desgraciadamente su autor no ha seguido desarrollando) es el Adaptative Software Development, esta metodología parte de la idea de que las necesidades del cliente son siempre cambiantes durante el desarrollo del proyecto (y posteriormente a su entrega). Cosa que nos viene que ni pintada para los sistemas decisionales

Su impulsor es Jim Highsmith, la novedad de esta metodología es que en realidad no es una metodología de desarrollo de software, sino un método (como un caballo de troya) a través del cual inculcar una cultura adaptativa a la empresa ya que su velocidad de adaptación a los cambios marcará la diferencia entre una empresa próspera y una en declive.

La incertidumbre y el cambio continuo son el estado natural de los sistemas de información, pero parece ser que muchas organizaciones aún no son conscientes de ellos. La idea de “finalizar” un proyecto carece de sentido porque debe seguir adaptándose y con mas razón si se trata de un sistema decisional. Siempre estamos cambiando nuestros puntos de vista.


Así pues tenemos una metodología (mas bien un metodito) con 4 objetivos claros (independientemente de que el proyecto sea un éxito)

  1. Concienciar a la organización de que debe esperar cambio e incertidumbre y no orden y estabilidad.
  2. Desarrollar procesos iterativos de gestión del cambio.
  3. Facilitar la colaboración y la interacción de las personas a nivel interpersonal, cultural y estructural.
  4. Marcar una estrategia de desarrollo rápido de aplicaciones pero con rigor y disciplina.El ciclo de vida que propone se basa en tres fases

El ciclo de vida que propone se basa en tres fases

Fase 1: Especulación. Se inicia el proyecto y se planifican las características del aplicativo a desarrollar.

Fase 2: Colaboración. en esta el equipo de desarrollo se encarga de implementar las características

Fase 3: Aprendizaje. En ella se revisa su calidad, se aprende de los errores y se vuelve a iniciar el ciclo de desarrollo y/o se entrega al cliente.

Pero lo importante no son las fases ni nada por el estilo, lo realmente importante es que cambia la semántica de la creación de sistemas de información:

En lugar de analizar, diseñar, implementar, etc.. que es el lenguaje habitual con una semántica de infalibilidad y definitud (creo que me he inventado esta palabra) algo jactante, pasamos a especular, colaborar y aprender juntos y eso creo que es una buena característica para una metodología, sea cual sea su ámbito de actuación.


Por favor no me pongais ningún comentario a esta entrada (estoy probando la psicología inversa a ver si consigo mas colaboración) :-D

domingo, noviembre 19, 2006

Kimball 1 - Inmon 1 (Usabilidad vs Representación)


La "lucha" Kimball vs Inmon es ya de todos conocida, pero quizás no lo sea tanto las aseveraciones y mensajitos que ambos se han lanzado.

Kimball aseguró en 1997 su modelo multidimensional era "la única manera viable de diseñar bases de datos destinadas a su uso directo por parte de un usuario final".

Casi todos le siguieron la corriente, pero obviamente algunos valientes se le tiraron a la yugular entre ellos Inmon en 2000 cuando dijo que si diseñas un DWH desde el punto de vista de análisis de un solo individuo condenas al resto a su mismo punto de vista y que dificilmente en el modelo dimensional puedes incluir información no incluida en el foco original del análisis.

Pero no solo Inmon cuestiona este punto de vista, tambien Haughey en el 2004 comenta que "el mundo no es una estrella" y que el modelo multidimentional no puede representar de forma efectiva escenarios complejos de negocio.

Con lo que el primer gol de lo asigno a Inmon, así pues Kimball 0 - Inmon 1.

Pero mira por donde este grupo de investigadores decide mirar si la aseveración un poco prepotente de Kimball con la que hemos empezado era cierta o no y publican el siguiente artículo:

Comparing the Effect of Alternative Data Warehouse Schemas on End User Comprehension Level
David Schuff
209F Speakman Hall, Fox School of Business, Temple University
Karen Corral
BA297L, W.P. Carey School of Business, Arizona State University
Ozgur Turetken
209G Speakman Hall, Fox School of Business, Temple University

En el que hacen un estudio de como ambos modelos son vistos por los usuarios finales y como afectan ambos modelos a la usabilidad decisional.
La conclusión del artículo (que lo podeis descargar entero) hace que el marcador se iguale a 1, ya que concluye que para usuarios con poca experiencia el modelo dimensional es mucho mas usable y productivo.

Así pues por un lado ganamos capacidad para representar escenarios complejos pero necesitamos usuarios listos y expertos, mientras que por el otro perdemos capacidad de representación pero ganamos que cualquiera pueda usuarlo.

De momento 1-1.

¿Alguien se anima a meter algún gol mas?
¿Creeis que es lícito sacrificar esa capacidad de representación en pro de la usabilidad?.

miércoles, octubre 25, 2006

Tres enfoques para una metodología DWH

Buscando metodologías de BI, me he encontrado con el siguiente artículo:

Data Warehouse Methodology:A Process Driven Approach
Claus Kaldeich and Jorge Oliveira e Sá
Universidade do Minho, Escola de Engenharia
Departamento de Sistemas de Informação, Campus de Azurém
4800-058 Guimarães, Portugal

No es precisamente lo que estaba buscando pero en la introducción hace referencia a los tres enfoques que puede tener una metodología para datawarehouse.
La idea es que el enfoque de toma de requisitos (requeriment-driven approach) no sirve para este tipo de proyectos ya que este enfoque no satisfará las demandas futuras de los usuarios, y los usuarios dificilmente son capaces de definir y explicar como toman sus decisiones.

Así pues, nos brinda tres alternativas, para que nos hagamos nuestra propia metodología.
  • Data-Driven approach: Este enfoque deja de lado a priori a los usuarios, los objetivos de la organización y se centra en los datos. En como están estructuraros, en quien los usa, en la forma en que los usan. Se fija en los datos con mayor tasa de acceso, aquellos que se consultan con mayor frecuencia, como se relacionan entre ellos, que consultas suelen venir asociadas. Son los datos los que dirigen el proceso. Es un poco como el doctor House, los usuarios mienten, pero los datos no.

  • Goal-Driven approach: Este enfoque se centra en el objetivo de los procesos de la organización y se basa en el análisis de la interación de tanto clientes como usuarios hacen para conseguir dicho objetivo. A partir de ahí establece necesidades de información e interrelaciones entre ellas que darán lugar a la estructura del datawarehouse. Fijaos que este método da lugar una estructura quizás no del todo estructurada, mas al estilo de Inmon que de Kimball.

  • Demand-Driven (or user-driven) approach: Este enfoque asume que todos los usuarios conocen la estrategia empresarial y se comportan de forma coherente con ella. Si realmente son ellos los que van a tomar las decisiones, son ellos los que deben dirigir el proceso de creación del datawarehouse. Se empieza con un primer prototipo muy rudimentario basado en los objetivos empresariales y a partir de ahí los usuarios definen las necesidades de información, las preguntas que le van a hacer al DWH, etc.. .......¿no os recuerda de forma clara a las metodologías ágiles?
Pero aquí solo estamos hablando de DWH, con lo que hago la siguiente reflexión ....
¿que pasaría si utilizasemos estos tres enfoques en cada uno de los ámbitos de toma de decisiones?

Conclusión:
  • Seguramente nos encontraríamos que en las decisiones operacionales el Data-Driven Approach será el mas adecuado, mientras que en las tácticas un Demand-Driven Approach nos dará mas beneficio y obviamente en las decisiones estratégicas el Goal-Driven Approach será el mas útil.


jueves, octubre 19, 2006

¿Cuando puedo aplicar una metodología ágil?

He hablado mucho de metodologías ágiles, y parece que se pueden adaptar fácilmente a las necesidades del datawarehouse, pero aún no hemos visto cuando debemos utilizar un metodología ágil, independientemente de que el proyecto sea o no de Business Intelligence. Cada proyecto necesita de una metodología adecuada a él que le garantice el éxito. Necesita que se adecue no solo a sus funcionalidades a desarrollar, sino además al equipo de desarrollo, a los recursos disponibles, al plazo de entrega, al entorno socio-cultural, la cultura empresarial, etc…

Un buen profesional no debería cerrarse en una metodología de forma ciega, siempre se ha de cuestionar si es la apropiada antes de empezar el proyecto. Pero aún así existen algunas reglas básicas, de “sentido común”, que voy a tratar de resumir en .....


Las Siete preguntas que nos darán la llave de la agilidad.
(No sé que me pasa con el siete, se admite debate) :-D


Pregunta 1 ¿Cómo es de grande tu proyecto?.

Si se trata de un proyecto pequeño y/o con un equipo reducido de desarrollo, de tres a ocho personas, tienes una oportunidad de experimentar con los métodos ágiles

Pregunta 2 ¿Son tus requisitos dinámicos?.

Si te encuentras ante un ámbito de actuación los puntos de vista de análisis estan constantemente cambaindo como podría ser un datamart de fuerza de ventas, entonces la metodología ágil te ayudará a responder a esta variabilidad
Si estas en un ámbito en el que el dinamismo es poco, por ejemplo el análisis de los estados financieros y contables, en el que los KPI son casis siempre los mismos para todas las empresas, quizás no te sea tan útil.

Pregunta 3 ¿Qué pasa si tu sistema falla?.

Si te encuentras en un sistema crítico en el que cualquier fallo involucre grandes pérdidas humanas o grandes cantidades de dinero, por favor no utilices las metodologías ágiles.
Si nuestro Datamart involucra decisiones operacionales a corto plazo por ejemplo en la creacion de un Business Activity Monitoring, mejor asegurarnos el éxito con una metodología orientada al plan.

Pregunta 4 ¿ Tu cliente tiene tiempo para dedicarlo al proyecto?.

Si la respuesta es no olvidate de la metodología ágil haz el tipico contrato legal o mejor no aceptes el proyecto

Pregunta 5 ¿Cuantos perfiles juniors tienes en tu equipo de desarrollo?.

Las metodologías ágiles requieren de una gran madurez, experiencia y una dosis de talento. Deben de ser equipos con gente seniors o semi-seniors. Si tu equipo lo constituyen principalmente novatos lo mejor es que no lo intentes con las metodologías ágiles.

Pregunta 6 ¿Cuál es la cultura empresarial de la empresa en la que se va a desarrollar el proyecto?.

Las metodologías ágiles requieren de cierto ambiente “informal”, que fomente la comunicación de igual a igual. Si la organización en la que se quiere desarrollar el proyecto tiene un alto grado de ceremonia, pomposidad y jerarquías estrictas, no deberías utilizar las metodologías ágiles.

Pregunta 7 ¿Te apetece?
Realmente tienes ganas de probar una metodología ágil, aprender cosas nuevas supone casi siempre un nuevo sacrificio.


Si tu equipo es pequeño y esta formado mayoritariamente por gente con talento y experiencia, si el cliente final está involucrado y no impone barreras de comunicación, si los requisitos son altamente cambiantes, si no es proyecto crítico y no es demasiado grande, y te apetece probar una metodología ágil, no lo dudes, es el momento de experimentar con las metodologías ágiles.

miércoles, octubre 04, 2006

Si no eres de Vulcano necesitas Fuzzy OLAP


Como bien dice Angel Agueda en un blog "Inactivad es sinonimo de mucho trabajo"
Así que voy a hacer una pequeña anotación para recordaros que sigo en la brecha, a pesar de que el ritmo no es que yo desearía.

¿Recordamos todos Star Trek? Supongo que si, sabreis entonces que Spock( y todos los de Vulcano), regían sus acciones sobre la más estricta de las lógicas, sin inmutarse ni pestañear, refrexionaba todo cuantitativamente y daba la respuesta más lógica. Mítica es la frase "el bienestar de la mayoria supera al de la minoria y de a uno solo" con el que Spock decide que es más lógico sacrificarse él por salvar a toda la tripulación del Enterprise.

El caso es que su contrapunto en la serie era el Capitán Kirk que tomaba las decisiones sin meditarlas demasiado, con el estómago como quien dice, al mas puro estilo "humano".

Así pues, si fueramos de Vulcano nos serviría perfectamente la estructura OLAP tradicional (como ya comenté en el post Mi cerebro ... ¿un producto cartesiano?), pero obviamente no tenemos esa capacidad y el cosquilleo en el estómago y la intuición a veces tienen un peso más que específico dentro de nuestra toma de decisiones. Eso me recordó que quizás la lógica difusa (fuzzy logic) podría ayudarnos mas que la lógica pura, y que quizás un análisis cualitativo fuera mas adecuado para la toma de decisiones. Sin muchas esperanzas me puse a buscar y ¡oh! ¡Sorpresa! alguien ya estaba investigando en esa linea.

El articulo con el que he topado es


Fuzzy OLAP cube for qualitative analysis
Pavan Kumar, K.V.N.N.; Radha Krishna, P.; Kumar De, S.;
Intelligent Sensing and Information Processing, 2005. Proceedings of 2005 International Conference on
4-7 Jan. 2005 Page(s):290 - 295
Digital Object Identifier 10.1109/ICISIP.2005.1529464


Como siempre de investigadores de la India que cada vez están mas fuertes (o tienen más tiempo libre). El artículo tiene la bondad de no solo teorizar sino de implementar un ejemplo práctico con un cubo de ventas, que si bien es muy limitado si que nos da una idea de como utilizar la lógica difusa en la consulta de cubos OLAP.

El ejemplo con el que juegan es ¿cuando un cliente/vendedor se puede calificar de Bueno, o Medio o Malo? ¿Lo tenemos claro? ¿Es totalmente estricto o dejamos cierto margen de variabilidad?. Pare ello utiliza algoritmos de lógica difusa mezclados con algoritmos de mineria de datos sobre un cubo OLAP. Es una buena aproximación sobre la que seguiré reflexionando.

sábado, septiembre 16, 2006

¿Inmon o Kimball? o cuanto apreciamos la trazabilidad decisional

Despues de un tiempo de silencio (la entrada en septiembre ha sido un poco dura) y tras hablar de ontologías, vamos a bajar de nuevo a la parte de decisiones operacionales y tácticas.
En este ambito la creación de los Datawarehouse tienen dos grandes gurús, por un lado el archiconocido Kimball con su modelo multidimensional, y por el otro el quizás menos conocido pero no menos importante Inmon.

Me he estado leyendo este artículo que la verdad aporta poco y no es mas que una revisión de todos los conceptos de un datawarehouse, pero que me ha servido para reflexionar cual es mi propio de creación de datawarehouse y cual sería el más apropiado para una metodología ágil

MODELING STRATEGIES AND ALTERNATIVES FOR DATA WAREHOUSING
Articulo de Nenad Jukic publicado en communications of ACM en abril de este año.

Y me ha sorprendido comprobar que estoy mas de acuerdo con las tesis de Inmon que con las de Kimball, yo que he sido un fiel seguidor del primero

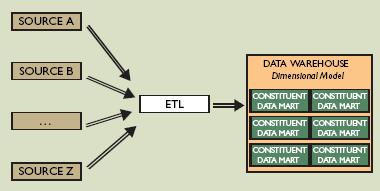
Aquí podemos ver dos típicas arquitecturas al "estilo Kimball"


El primer modelo es el utilizado en algunas implementaciones MOLAP puras en las que tenemos varios procesos ETL, que se conecta a diferentes fuentes de datos y generamos los diferentes datamarts dimensionales. Son generalmente datamarts independientes entre ellos para el uso de un solo departamento o incluso de una sola persona.


El segundo modelo es el Kimball mas corporativo en el que un proceso ETL nutre un espacio datawarehouse en el que se comparten las dimensiones entre diferentes puntos de vista y en el que los datamarts de cada departamento forman utilizando los hechos y las dimensiones ya establecidas para toda la compañia.


Todo normal hasta aquí y perfectamente de acuerdo con ello, yo mismo he hecho decenas de dwh utilizando el dogma Kimball


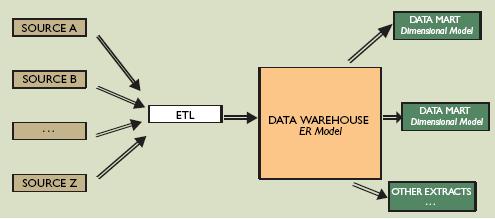
Pero miremos ahora el "estilo Inmon"
Coincide con Kimbal en un único proceso ETL que nutra un DWH corporativo, pero el que él nutre no es dimensional es un DWH basado en el modelo Entidad-Relación.
La idea de Inmon es que el modelo E-E mucho mas rico y adaptable que el multidimensional.

Una vez tenemos el DWH E-R corporativo generamos los datamarts dimensionales que queramos, y no solo eso, nos puede servir para crear cualquier otra extracción para cualquier otro sistema decisional, como puede ser para mineria de datos o para sistemas expertos, por ejemplo.

Lo que me gusta de Inmon es que no se cierra a un solo modelo y no solo eso, además su arquitectura mejora la trazabilidad decisional. Con ella podemos desgranar un valor en un KPI hasta una serie de análisis y reports que lo expliquen en detalle, tan en detalle como nos permiten los modelos E-R que tenemos en nuestros sistemas operacionales.

Parece maravilloso, pero el problema es que es mas costoso de mantener y de implementar. El de Inmon es un modelo que mira a largo plazo y para una metodología ágil el largo plazo es secundario. Para adaptarlo y no perder la agilidad de por ejemplo el primer modelo de Kimball, yo he utilizado a veces lo que he llamado la "Starting Area".

Si el proyecto necesita de una trazabilidad que llegue hasta el ultimo nivel de detalle, lo mejor es crear un capa que sea una copia exacta de los diferentes modelos relacionales de los que se nutre el modelo dimensional. Una simple BULK COPY nos servirá inicialmente, no hace falta unificar el modelo E-R de las diferentes fuentes origen en uno solo, eso es demasiado trabajo. La idea es dejar la semilla de una capa relacional por debajo del dimensional y que ambas crezcan de forma conjunta alo largo del proyecto.

Creo que esta sería la mejor opción para una metodología ágil, nos permitirá tener la rapidez del modelo Kimball y la visión de futuro del modelo Inmon.

domingo, septiembre 03, 2006

De la Web Semántica a la Ontología Decisional (2ª parte)

Todo Ontología se compone de tres partes:
1) Clases e instancias de los objetos que la componen
2) Propiedades que establecen relaciones
3) Reglas para modelar el conocimiento y los comportamientos complejos ( Creación, Restricción y Reacción).

Si no aplicamos el último componente (las reglas) obtendremos o bien una ontología ligera o bien una Taxonomia que no es el objetivo que buscamos en principio.

Así pues ,si queremos tener una ontología decisional, ¿debemos utilizar reglas?.

La utilización de reglas nos origina el problema de la capacidad del motor de inferencia, cuando la base de conocimiento sobre la que se intenta inferir es muy grande, los motores tienen graves problemas de escalabilidad, siendo inviables hoy en dia.

  • RuleML (http://www.ruleml.org/)es un ejemplo de lenguaje de reglas basado en XML, si la base de conocimiento no es demasiado extensa, funciona perfectamente. Pero...
  • ........¿que tipo de toma de decisiones tiene una base de conocimiento relativamente pequeña?. Desde luego las decisiones estratégicas no, con lo que una de mis primeras intuiciones, aplicar reglas basadas en conocimiento en los sistemas estratégicos, parece que se va limitar a ambitos de actuación muy especializados. Mi gozo en un pozo.

La no utilización de reglas nos origina el problema de la poca capacidad expresiva del conocimiento. Hay varias alternativas una de ellas es utilizar lenguajes lógicos que alternen capacidad expresiva y posibilidades computacionales reales, ya que la lógica de predicados de primer orden es intrinsecamente indecidible.

  • OWL-DL, reduce las posiblidades expresivas de la lógica de predicados de primer order obteniendo un lenguaje de razonamiento de capacidad exponencial pero que puede ser procesado (ya no es indecidible, aunque es exponencial). OWL-DL tiene la potencia suficiente como para representar un modelo de Entidad-Relacion (E-R) (OWL-DL can represent E-R Models). Actualmente se esta investigando como mapear modelos OWL-DL sobre diagramas UML. Con lo que se nos abriría una via importante para su utilizacion en entornos decisionales operacionales.

La otra alternativa es la utilizacion de ontologías lígeras (sin reglas) pero fortalecidas con "razonadores" que expanden las consultas utilizando una base de datos relacional y por lo tanto todas las capacidades de ejecución y optimización que poseen en la actualidad. Esta alternativa no plantea problemas de escalabilidad, y aunque no es tan purista, posiblemente sea mas fácil de implantar para entornos tácticos y estratégicos.

Así pues ya tenemos una idea de como crear nuestras ontologias decisionales, pero lo que no sabemos es lo fundamental... ¿como le hago una pregunta? ¿me sirve el SQL de toda la vida?. Obviamente no. Existen lenguajes de consulta específicos para atacar a las ontologías, uno de ellos es SPARQL( Un lenguaje de consulta para RDF ). No es el único, exiten otros como RDQL y RQL, pero es el que parece que se convertirá en estándar de la W3C.

Así que ya podemos pensar en que al SQL le ha salido un nuevo compañero de viaje. Sin duda en el futuro los sistemas decisionales hablaran SPARQL.


jueves, agosto 31, 2006

De la Web Semántica a la Ontología Decisional (1ª parte)

El auge de estudios que se están produciendo entorno a la Web Semántica está disparando hacia la madurez a la Ingeniería Ontológica a pasos agigantados y en el camino se están sembrando una gran cantidad de conceptos que nos pueden servir para definir una nueva forma de entender los sistemas decisionales.

Así que pensando que cualquier analogía es buena, me lancé a leer mas sobre el tema, de entre los articulos que he ido hojeando, dos son los que mas idea me han ido dando y que por suerte os podeis descargar desde la web de Novatica. Novática: revista creada en 1975 por ATI (Asociación de Técnicos de Informática)

Son estos:


  1. La Web Semántica: fundamentos y breve "estado del arte" , Luis Sánchez Fernández, Norberto Fernández García [resumen][contenido completo en formato PDF - 285 KB]
  2. Recuperación de información en la Web Semántica . David Vallet Weadon, Miriam Fernández Sánchez, Pablo Castells Azpilicueta [resumen][contenido completo en formato PDF - 340 KB]
Si os gusta el tema os recomiendo que os los leais detenidamente y los complementeis con los articulos que Javier Urrutia esta publicando recientemente en su blog con respecto a la aplicacion empresarial de ontologias

El primer paso que tenemos que dar para pasar de la sintaxis a la semántica es dotar a los usuarios de un vocabulario común en el que todos utilicemos las misma palabras con los mismos significados semánticos, eso o bien pedirle peras al olmo. Cualquier de las dos nos vale como utopía.

Representación gráfica de las busquedas en google, proyecto OPTE http://opte.org


Eso es imposible y ademas no deseable, para obtener un sistema decisional orientado hacia la semántica, lo primero que debemos pedirle es precisamente que los diferentes tipos de usuarios utilicen su propio vocabulario con sus propias connotaciones de negocio.

Como en la web semántica este requisito es idéntico, la W3C ha creado un lenguaje para representar (y anotar) conocimiento en la web, es el RDF (Resource Description Framework) pensado para anotar documentos web y xml.

Ahora bien, yo me pregunto: ¿como trabajan la mayoria de los Suites de Business Intelligence actualmente? ... pues en entorno web. Todos los informes generados son presentados a través de un navegador, ¿que pasaría si los propios usuarios pudieran dotar de anotaciones que aportasen significado a estos informes?. Y no solo eso, ¿qué pasa con todos esos informes que circulan en documentos word, powerpoints y excel por las empresas (a veces el 80% de la información de caracter analítico y decisional) que pueden ser exportados a xml?. ¿Qué pasaría si el MS Office (por decir uno) te dotase de la capacidad de hacer anotaciones semánticas en tus presentaciones de resultados?. Como veis la capacidad de dotar de semántica a todos nuestros actuales sistemas de análisis esta a punto de ser realidad aprovechándonos de la web semántica.
Existen algunas herramientas que estan saliendo que facilitan la anotación manual (por ejemplo SHOE KnowledgeAnnotator ), pero.... ¿me sirve de algo?. Si tengo que ir informe por informe anotando manualmente, posiblemente me canse o las anotaciones sean de menor valor o rutinarias. Para ello existen sistemas de anotación semiautomáticos como puede ser PANKOW que exploran el documento buscando referencias a conceptos descritos en ontologías.

Con lo que llegamos a mi primera conclusión: La anotación semántica decisional debe tener un caracter semi-automático

Vale, ya tengo anotados todos mis informes y análisis, pero para anotarlos necesito hacer referencia implícita o explícitamente a una ontología, quiera yo o no quiera, y esa ontología si quiero hacer algo con ella debo procesarla y compartirla con el resto de usuarios de mi organización.
Aunque parezca una perogrullada, para tener una ontología debo especificarla antes, pero ¿como las especifico?, yo nunca he creado ninguna y las que utilizo están implitas en mi cerebro, ¿que tengo que poner? ¿por donde empiezo?. No os preocupeis, por suerte hay gente muy lista en todo el mundo y algunos de ellos estan pensando en una metodología para el desarrollo de ontologías. Una de las inciativas mas conocidas es METHONTOLOGY . La siguiente pregunta que me viene a la cabeza es ¿será una metodología ágil o el armatoste de siempre?. La respuesta es.....que es el armatoste de siempre, es del año 1997 y el ciclo que proponen no es que sea demasiado ágil. Así que seguiré buscando por si hay alguna.
http://rhizomik.net/~roberto/thesis/figures/MethontologyLifeCycle.pdf
Con lo que llegamos a mi segunda conclusión: Necesitamos de una metodología agil para crear ontologías decisionales que puedan ser aplicables al negocio
Tambien necesitaremos herramientas de creación de ontologías decisionales, pero con el tiempo estarán integrads dentro de las suites de BI, Por ahora existen varias en el desarrollo, pero quizás la que esta teniendo mas éxito es Protegé realizado en la Universidad de Stanford
Pero sigamos explorando las caracteristicas que podemos aprovechar de la Web Semántica.
En un sistema decisional, un grupo de usuarios, posiblemente del mismo departamento, deberán compartir una ontología común, pero el resto de usuarios de otros departamentos posiblemente tengan las suyas. El concepto Margen para un departamento es posible que sea diferente del que tiene otro, por ejemplo si incluimos o no incluimos los abonos o los impuestos, pero en el informe se utiliza la misma palabra y cada uno entiende el concepto según su ontología.
Obviamente, si no queremos nichos de información aislados y pequeños Reinos de Taifas Reinos de Taifas , estas ontologías deben poder relacionarse. para ello nace una linea de investigación llamada onthology mapping que trata de resolver el problema de detectar qué dos conceptos definidos en dos ontologías se relacionan entre si de alguna manera o si son el mismo concepto.
Con lo que llegamos a mi tercera conclusión: Necesitamos mapear las diferentes ontologías decisionales, no solo por departamentos sino también por tipología de decisión (operacional, táctica, estratégica) aunque esto último es mas una intuición que una conclusión sólida.
Y como se me esta haciendo muy largo, dejaré para otro el siguiente post los motores de inferencia y las reglas decisionales.

lunes, agosto 21, 2006

7 Paradigmas a romper para ser ágiles

En uno de los comentarios de los ultimos post Rafa comentaba acerca de los DWH. "No todas las organizaciones son suficientemente maduras para lanzarse a ello...".

Eso me hizo reflexionar sobre la idea de qué debe cumplir una organización para poder abordar un proyecto utilizando metodologías ágiles, que paradigmas se han de romper para tener garantías de éxito en un proyecto de este tipo. El resultado son estos siete puntos (sí otra vez siete, como Los Siete Samurais)

1) Cambiar el estilo de gestión de "orden y control" hacia "liderazgo y colaboración".

Una organización basada en una visión clásica de dar ordenes y controlar al personal, dificilmente podrá asumir un proyecto ágil. Las jerarquías estrictas de jefe-ordena y empleado-obedece, acabn indefectiblemente en situaciones en que las personas se limitan a hacer sus tareas y nada más sin aportar nada por lo que no se le pague. En un organización ágil, el coaching y el liderazgo colaborativo harán que el equipo de lo máximo de si. No queremos un jefe que mande, queremos un lider que motive. No queremos un control, queremos una colaboración.

2) Cambiar la cultura empresarial de "centrada en los procesos" hacia "centrada en las personas".

La visión única de control de procesos de negocio sin tener en cuenta las interacciones de estos procesos con las personas que los ejecutan tiene que desaparacer. Ya lo vimos en el anterior artículo, el éxito está en la interacion de las personas con los procesos y con la tecnología. Si queremos ser ágiles debemos organizar nuestra empresa en torno a las personas, que son las que pueden darnos esa agilidad, esa capacidad de adaptación a situaciones nuevas que no hayan sido previamente pensadas y modeladas en un proceso, pero que son vitales para la supervivencia de una orgnaización.

3) Cambiar la gestión del conocimiento no crucial de "explícito" a "tácito".

El conocimiento de una organización suele estar siempre en los cerebros de sus empleados, las organizaciones tienden a intentar guardarlo de forma explícita, absolutamente todo y al máximo nivel de detalle posible, eso nos deja en la penosa situación de documentar periodicamente nuestro conocimiento y claro no lo haces como lo explicarías de viva voz, porque has de ser formal y explícito. Precisamente este ansia de documentarlo todo, es loq ue ha veces nos corta las alas de la creatividad, perdemos tiempo en documentar en lugar de invertirlo en crear, en adquirir nuevo conocimiento. Prefiero documentar una idea genial en una servilleta de papel y que tener toneladas de documentos repletos de vacuidades.

Obviamente, esto nos deja en una situación bastante comprometida de dependecia de nuestros empleados, pero no nos engañemos, eso SIEMPRE es así, el autentico conocimiento esta en las personas, nos podemos engañar diciendo que no, pero es eso, un simple engaño.

4) Cambiar la comunicación de "formal" a "informal".

Si queremos hacer equipos, que colaboraren , compartan conocimiento, y funcione al unísono, no podemos encorsetarnos en comunicaciones rígidas, formales y llenas de burocracia.

5) Cambiar el rol del usuario final de "importante" a "fundamental".

En las metodologías tradicionales, el usuario o cliente formaba parte de la fase de análisis en la que tomabamos los requisitos del sistema. Con las metodología ágiles los usuarios finales forman parte del equipo de desarrollo y son una pieza fundamental del proyecto. Sin ellos, simplemente no hay proyecto.

6) Cambiar la estructura de la organización de "jerárquica" a "orgánica".

Debemos pasar de un entorno burocrático y altamente formal a una orgnaización felxible, reflexiva, participativa y que facilite la cooperación. Si os fijais las neuronas no están organizadas en forma de arbol jerárquico, sino en forma de red. Cada persona es como una neurano del "cerebro" de la organización.

7) Cambiar los "roles estrictos" por "roles intercambiables".

En la revolución industrial teneia serntido, que una persona se especializase solo en una cosa, pero en la época actual, el poder intercambiar roles y funciones en un mismo proyecto, nos da la posibilidad de desarrollar nuevos puntos de vista y así atacar los mismos problemas desde diferentes puntos de vista. Nuestros empleados crecerán en motivación, en conocimiento y la empresa será mas adaptable.

Seguramente son 7 grandes barreras, pero hay que empezar a romperlas si queremos adaptarnos a los nuevos paradigmas

Modificación del 4/12/2006

Joserra ha escrito este estupendo complemente que no os podeis perder
La confianza y las metodologías ágiles.


lunes, agosto 07, 2006

7 Intervenciones para el éxito de un DWH (3ª Parte)


Con este post terminamos con las 7 intervenciones.

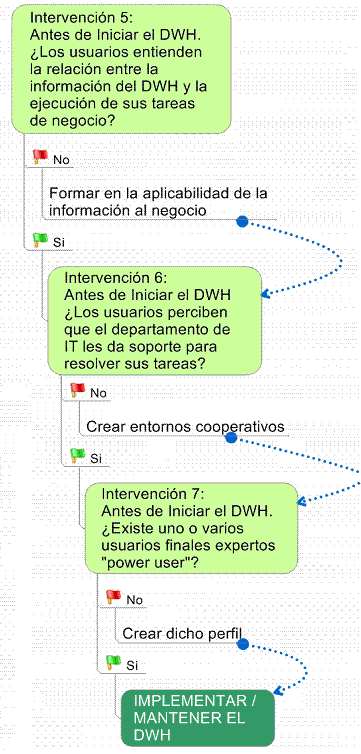
El punto de Intervención 5 es asegurarse de que los usuarios finales saben como aplicar la información extraída del DWH a sus tareas diarias. Si no saben como les puede ayudar el DWH obviamente no lo utilizarán y el DWH caerá en desuso y posteriormente en el olvido. Si no hay que realizar formaciones específicas con los usuarios para garantizar la aplicabilidad de la información.
En esta linea creo que no solo es necesario que los usuarios finales entiendan como aplicar la información a sus tareas diarias, sino que comprendan la globalidad del proceso del negocio (del cual estas tareas forman parte), el objetivo del mismo y las perturbaciones a las que puede ser sometido, tanto internas como externas a la organización.
Tener un mapa conceptual de lo que pueden significar diferentes metricas y valores en el ámbito del negocio es útil, pero si nos limitamos a repetir esa aplicabilidad sin entender el significado global nos arriesgamos a caer en la paradoja que a veces explico en clase la de "Los 12 monos" que repiten un proceso sin comprender el significado de lo que hacen. (El link aprovecho la adaptacion de Antonio Valle de esta paradoja que me llegó hace años por internet y que no se quién es el autor)
El punto de Intervención 6 es asegurarse que la relacion entre el departamenteo de sistemas de información y los usuarios finales es fluida. Si no encontramos con hermetismo por alguno de los dos lados, seguramente la implanción será un fracaso, es mejor retrasarla hasta propiciar un entorno colaborativo.
Fijaos que este punto es plenamente coincidente con las metodologías ágiles en los que los usuarios finales forman parte del equipo del proyecto, participando en las reuniones periodicas, aportando ideas, añadiendo o eliminando funcionalidades, pero como uno mas, no como el usuario al que se le pregunta cuando se tienen dudas y que lo que el diga luego nos servirá de excusa o de salvoconducto.
El punto de Intervención 7 es asegurarse que entre los usuarios finales va a haber uno que conozca muy bien tanto las capacidades del DWH como el uso de las herramientas de explotacion, lo que los autores llaman el "Power User" y a lo que yo llamo "el empollón gafotas" . Si queremos tener éxito en el uso continuo y a largo plazo del DWH es necesario una persona de negocio que explore todas las posibilidades y que ayude e incentive al resto de compañeros. No hay nada como un usuario que consigue maravillas con el DWH para que los demás imiten su camino.
Los autores dicen que si ese perfil no éxiste hay que crearl, en una metodología ágil ese usuario ya se crea durante el proyecto, ya que forma parte del equipo.
Ya hemos visto los 7 puntos de intervención que nos garantizarán el éxito ( o mejor dicho el no fracaso) de un DWH, muchos de ellos tienen coincidencias con las metodologías ágiles como hemos podido ver, con lo que mi propia conclusión de este artículo es que la aplicacion de una metodología ágil en la implantacion de un DWH nos acerca un poco mas al éxito que no las tradicionales.
Cuatro de la siete intervenciones están incluidas ya en las metodologías ágiles.
¿No os da eso qué pensar?